ما هو robots.txt وكيف تكتبه بشكل صحيح؟ (دليل 2026)
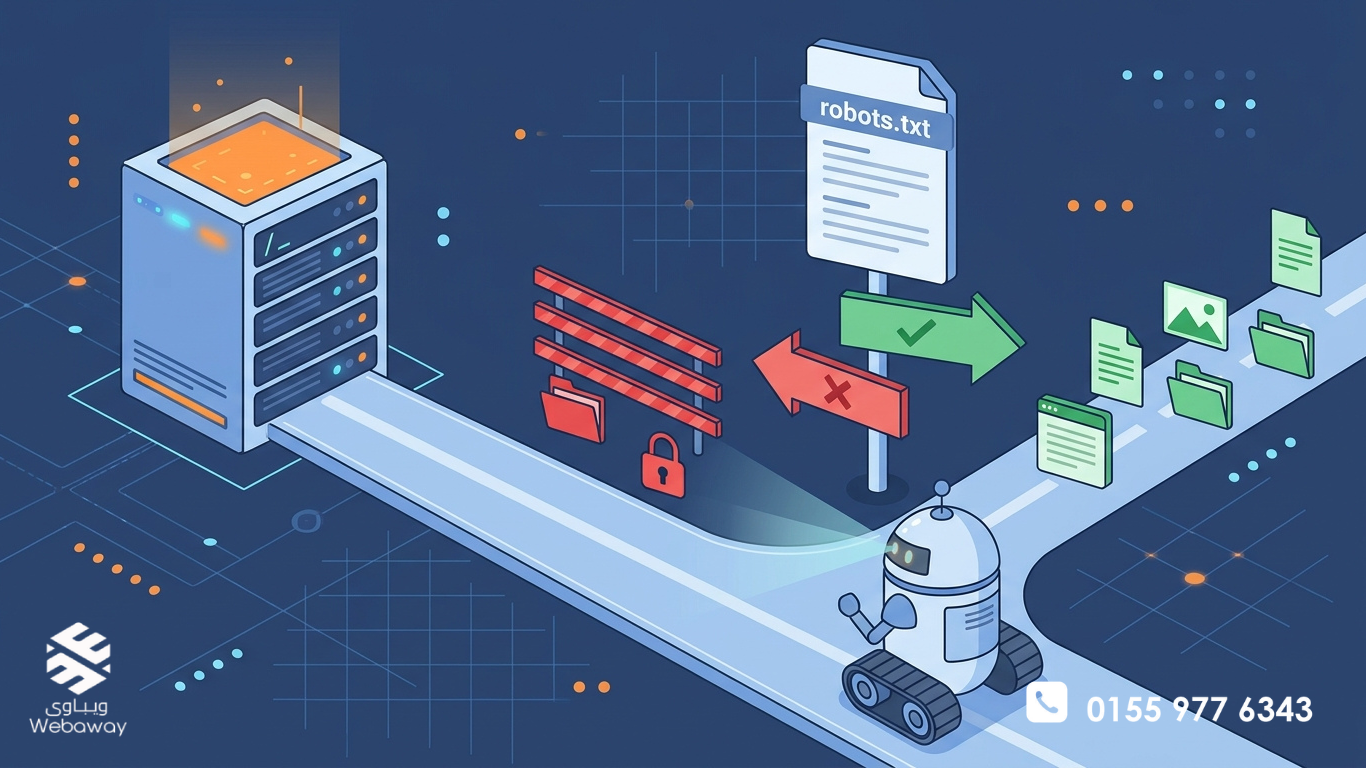
ملف robots.txt هو ملف نصي بسيط يوضع في جذر موقعك، ويخبر محركات البحث (الروبوتات) بالصفحات التي يُسمح لها بالزحف إليها والصفحات الممنوعة. لكنه ليس أداة أمان، ولا يمنع الصفحات من الظهور في نتائج البحث نهائياً.
باختصار: robots.txt هو “لوحة إرشادات” لمحركات البحث. يوجهها لتوفير وقت الزحف على صفحات غير مهمة (مثل سلة المشتريات أو لوحة التحكم)، ويوجهها إلى خريطة الموقع (Sitemap) لاكتشاف المحتوى المهم بسرعة. لكنه لا يحمي بياناتك، وأي شخص يمكنه فتح الرابط ورؤية المحتوى إذا لم يكن محمياً بشكل حقيقي .
في هذا الدليل، سنشرح ما هو robots.txt، وكيف تكتبه بشكل صحيح، والأخطاء الشائعة التي قد تدمر ظهورك في جوجل. ولو عايز تعرف إزاي تحسن ظهور موقعك بشكل عام، اقرأ عن موقعي لا يظهر في جوجل؟ دليل تشخيصي شامل من 5 خطوات.
📲 عايز تتأكد إن ملف robots.txt بتاعك مش بيمنع جوجل من موقعك؟ تواصل معنا على واتساب وهنفحصه معاك مجاناً.
أولاً: إيه هو robots.txt بالظبط؟
1. التعريف
robots.txt هو ملف نصي عادي (Plain Text) يتبع معيار “استبعاد الروبوتات” (Robots Exclusion Standard). يوضع في جذر الموقع بالظبط .
مثال: لو موقعك www.example.com، الملف لازم يكون في www.example.com/robots.txt.
2. إيه اللي بيعمله؟
بيتحكم في الزحف (Crawling): بيقول لمحركات البحث إيه المسارات اللي مسموح لها تزحفها وإيه اللي ممنوع .
بيقلل الحمل على السيرفر: لو موقعك كبير وفيه صفحات كتير غير مهمة، robots.txt بيمنع الزحف ليها ويوفر موارد السيرفر .
بيوجه محركات البحث للـ Sitemap: بيدل جوجل على مكان خريطة الموقع، عشان يكتشف الصفحات المهمة بسرعة .
3. إيه اللي مش بيعمله؟ (مهم جداً)
مش أداة أمان: أي حد يقدر يفتح رابط robots.txt ويشوف المحتوى. لو عندك صفحات حساسة (بيانات عملاء، لوحة تحكم)، لازم تحميها بـ كلمة مرور أو تسجيل دخول، مش robots.txt
مش بيمنع الظهور في نتائج البحث: لو صفحة ممنوعة في robots.txt لكن فيه روابط ليها من مواقع تانية، جوجل ممكن يفهرسها من غير وصف (تظهر في النتائج بدون Meta Description) .
الخلاصة: robots.txt أداة لتنظيم الزحف، مش للحماية أو الإخفاء الكامل.
robots.txt مش أداة أمان، لكنه بيتحكم في زحف محركات البحث. اعرف إزاي تكتبه صح، وأخطر 5 أخطاء بتدمر ظهور موقعك.
ثانياً: قواعد robots.txt الأساسية (كيف تكتبه)
1. القواعد الأساسية (Directives)
ملف robots.txt بيتكون من “مجموعات” (Groups). كل مجموعة بتبدأ بـ User-agent وبعدها أوامر Allow أو Disallow .
| القاعدة | إيه اللي بتعمله | مثال |
|---|---|---|
User-agent | بتحدد مين الروبوت اللي الأوامر دي بتتكلم معاه. * معناها “كل محركات البحث”. | User-agent: * |
Disallow | بتحدد إيه المسارات اللي ممنوع الزحف ليها. | Disallow: /admin/ |
Allow | بتحدد إيه المسارات اللي مسموح الزحف ليها (بتستخدم عادةً للاستثناء من منع أوسع). | Allow: /public/ |
Sitemap | بتحدد مكان خريطة الموقع. | Sitemap: https://example.com/sitemap.xml |
ملاحظة: لو مفيش Disallow خالص، أو لو الملف مش موجود، جوجل بيفترض إن كل حاجة مسموحة بالزحف .
2. أمثلة عملية (من الأسهل للأصعب)
المثال 1: السماح بكل حاجة (الوضع الافتراضي)
User-agent: *
Allow: /
ده معناه: كل محركات البحث مسموح لها تزحف كل حاجة. ده نفس عدم وجود الملف .
المثال 2: منع مجلد معين (زي لوحة التحكم)
User-agent: *
Disallow: /admin/
Disallow: /checkout/
ده معناه: ممنوع أي محرك بحث يزحف /admin/ أو /checkout/، لكن مسموح له يزحف باقي الموقع .
المثال 3: منع كل حاجة ما عدا مجلد معين
User-agent: *
Disallow: /
Allow: /public/
ده معناه: ممنوع الزحف لكل الموقع ما عدا مجلد /public/. (ملاحظة: Allow الأكثر تحديداً بياخد أولوية على Disallow الأوسع) .
المثال 4: منع نوع ملفات معين (زي PDF)
User-agent: *
Disallow: /*.pdf$
ده معناه: ممنوع الزحف لأي ملف بينتهي بـ .pdf. (استخدم $ عشان تحدد إن النهاية لازم تكون .pdf) .
المثال 5: استهداف محرك بحث معين
User-agent: Googlebot
Disallow: /nogooglebot/

User-agent: *
Allow: /
ده معناه: Googlebot ممنوع يزحف /nogooglebot/، لكن كل محركات البحث التانية مسموح لها تزحف كل حاجة .
ثالثاً: كيف تكتب robots.txt صح؟ (خطوات عملية)
الخطوة 1: استخدم محرر نصوص بسيط
مهم: استخدم Notepad أو TextEdit أو VS Code. مستخدمش Microsoft Word أو Google Docs، لأنهم بيضيفوا رموز غريبة (زي علامات الاقتباس المنحنية) بتلخبط محركات البحث .
الخطوة 2: احفظ الملف بترميز UTF-8
لما تحفظ الملف، اتأكد إن الترميز UTF-8. جوجل ممكن يتجاهل أي رموز مش من UTF-8 .
الخطوة 3: ارفع الملف في جذر الموقع
لو على استضافة عادية (cPanel): ارفع الملف عبر File Manager في المجلد الرئيسي (public_html أو www).
لو على WordPress: تقدر تعدل robots.txt من إعدادات إضافة SEO (زي Yoast أو Rank Math) → Tools → File Editor. (مستخدمش محرر الثيم، عشان متكسرش حاجة) .
الخطوة 4: اختبر الملف
افتحه في المتصفح: روح لـ موقعك.com/robots.txt وشوف لو ظاهر صح.
استخدم Google Search Console: فيه أداة “فحص عنوان URL” بتقولك لو الصفحة مسموح بالزحف ليها ولا لأ. أو استخدم تقرير robots.txt في Search Console عشان تشوف لو جوجل قادر يقرأ الملف .
الخطوة 5: أضف Sitemap
دايماً ضيف سطر Sitemap: في آخر الملف. ده بيساعد جوجل يكتشف صفحاتك أسرع .
رابعاً: أخطاء شائعة بتدمر موقعك
الخطأ 1: Disallow: / (منع الموقع بالكامل)
ده أخطر خطأ. لو حطيته، إنت كده بتمنع كل محركات البحث من كل الموقع. ده بيحصل غالباً لما حد بينسخ ملف من بيئة تجريبية (Staging) وينشره على الموقع الحقيقي .
الحل: راجع الملف بعد أي عملية نقل أو تحديث.
الخطأ 2: منع CSS و JavaScript
جوجل محتاج يشوف ملفات التصميم والأكواد عشان يفهم الصفحة صح. لو منعتهم، جوجل هيشوف موقعك “أعمى” — وده بيأثر على الترتيب .
الحل: متمنعش /wp-content/ أو /wp-includes/ أو أي ملفات CSS/JS.
الخطأ 3: الخلط بين robots.txt و noindex
robots.txt Disallow: بيمنع الزحف، لكن الصفحة ممكن تظهر في النتائج (بدون وصف) لو فيه روابط ليها.
noindex: بيمنع الفهرسة تماماً.
الحل: لو عايز تخفي صفحة من نتائج البحث نهائياً، استخدم noindex (مش Disallow) .
الخطأ 4: الملف مش في الجذر
لو حطيت robots.txt في /pages/robots.txt، جوجل هيتجاهله تماماً. لازم يكون في الجذر .
الخطأ 5: الملف كبير جداً
جوجل بيوقف قراءة robots.txt لو حجمه عدى 500 كيلوبايت. استخدم أنماط عامة (زي /*.pdf$) بدل ما تمنع كل ملف لوحده .
جدول ملخص: قواعد robots.txt الشائعة
| الهدف | الكود | ملاحظة |
|---|---|---|
| السماح بكل حاجة | User-agent: * + Allow: / | الوضع الافتراضي |
| منع مجلد | Disallow: /admin/ | استخدم / في الآخر |
| منع صفحة واحدة | Disallow: /page.html | محدد |
| منع نوع ملفات | Disallow: /*.pdf$ | استخدم $ |
| السماح لمجلد جوه ممنوع | Allow: /public/ | Allow الأكثر تحديداً بياخد أولوية |
| إضافة Sitemap | Sitemap: https://example.com/sitemap.xml | دايماً أضفه |
| منع محرك بحث معين | User-agent: Googlebot + Disallow: / | استخدمه بحذر |
خامساً: أسئلة شائعة
س: إيه الفرق بين robots.txt و noindex؟
ج: robots.txt بيمنع الزحف (Crawling)، لكن الصفحة ممكن تظهر في النتائج. noindex بيمنع الفهرسة (Indexing) تماماً، فالصفحة مش هتظهر. لو عايز تخفي صفحة، استخدم noinde
س: هل robots.txt بيحمي صفحاتي الحساسة؟
ج: لأ. أي حد يقدر يفتح robots.txt ويشوف المسارات. الحماية الحقيقية بكلمة مرور أو تسجيل دخول .
س: إزاي أعرف إن robots.txt بيمنع جوجل من موقعي؟
ج: في Google Search Console → Pages → شوف لو فيه “Blocked by robots.txt”. أو استخدم URL Inspection لأي صفحة، وشوف لو “Crawling allowed” .
س: إزاي أسمح لجوجل يزحف موقعي بالكامل؟
ج: إما مسح كل Disallow (أو تخلي الملف فاضي)، أو تحط User-agent: * و Allow: /. ده كفاية .
س: هل لازم أضيف Sitemap في robots.txt؟
ج: مش إلزامي، لكنه مفيد جداً. بيساعد جوجل يكتشف صفحاتك أسرع .
س: إزاي أمنع جوجل من زحف صور موقعي؟
ج: استخدم User-agent: Googlebot-Image و Disallow: /images/ (أو المسار اللي فيه صورك) .
س: هل robots.txt بيأثر على السيو؟
ج: بشكل غير مباشر. لو منعت زحف صفحات مهمة، مش هتتفهرس ومش هتظهر. لو منعت CSS/JS، جوجل مش هيفهم موقعك صح. لكن robots.txt نفسه مش عامل ترتيب .
سادساً: الخلاصة
robots.txt هو أداة لتنظيم الزحف، مش للحماية أو الإخفاء.
حطه في الجذر (مش في مجلد فرعي).
استخدم محرر نصوص بسيط (مش Word).
احفظه بترميز UTF-8.
أضف Sitemap دايماً.
متستخدمش Disallow: / إلا لو عايز تخفي الموقع بالكامل (وده مش هتعمله في موقع حقيقي).
متخلطش بينه وبين noindex — لو عايز تخفي صفحة، استخدم noindex.
اختبره بعد أي تعديل باستخدام Search Console أو المتصفح.
ابدأ بمراجعة robots.txt بتاعك النهاردة. لو لقيت Disallow: / أو منع لـ CSS/JS، صلحه فوراً. ولو عايز تعرف إزاي تحسن ظهور موقعك بشكل عام، اقرأ عن موقعي لا يظهر في جوجل؟ دليل تشخيصي شامل من 5 خطوات.
📲 عايز تتأكد إن robots.txt بتاعك مش بيمنع جوجل من موقعك؟ تواصل مع فريق WebAway على واتساب — هنفحص الملف معاك ونقولك لو فيه أي حاجة محتاجة تعديل. اطلب عرض سعر مخصص الآن.